
Sevgili Okuyucularımız,
Yapay zekâ ekosisteminde rekabet hız kesmeden devam ederken, modellerin başarısı kadar bu modellerin nasıl ve hangi kaynaklarla eğitildiği de gündemin ilk sıralarındaki yerini koruyor. Son dönemde Anthropic’in Moonshot AI (Kimi), DeepSeek, MiniMax ve Alibaba gibi Çin merkezli yapay zekâ laboratuvarlarına yönelttiği kapsamlı distilasyon saldırıları suçlamaları, yapay zekâ etiğinde sıklıkla göz ardı edilen kritik bir boyutu yeniden tartışmaya açtı: Sentetik veri ve distilasyon kaynaklarının etik meşruiyeti.
Peki bir modeli eğitirken kullanılan bilginin ve verinin etik yollarla elde edilmesi tam olarak ne anlama geliyor? Modellerin birbirinden öğrenmesi teknik bir inovasyon mu, yoksa etik sınırların ihlali mi?
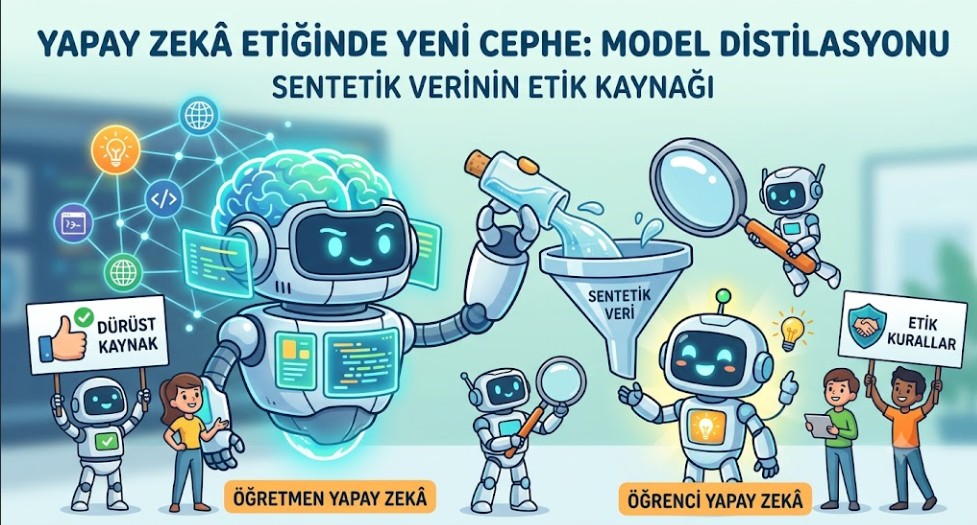
Model Distilasyonu Nedir? Eğitim için Kestirme Bir Yol Olabilir mi?
Model distilasyonu, temel anlamda büyük, karmaşık ve yüksek yetenekli bir öğretmen modelin ürettiği çıktıların, daha küçük ve düşük maliyetli bir öğrenci modeli eğitmek için kullanılması sürecidir. Sıfırdan bir öncül model eğitmek yüz milyonlarca dolar, devasa bir veri kümesi ve muazzam bir hesaplama gücü gerektirir. Distilasyon ise bu süreci çok daha ucuza ve kısa sürede gerçekleştirmenin yolunu sunar: öğrenci model, öğretmen modelin mantık yürütme, kod yazma veya analiz yeteneklerini, onun ürettiği yanıtları veri kümesi olarak kullanarak adeta kopyalar.
Anthropic’in açıklamalarına göre sahte hesaplar ve vekil ağlar kullanılarak Claude modelinden milyonlarca etkileşim çekilmiş, bu verilerle rakip modeller eğitilmiştir. Bu durum, teknik olarak bir yetenek aktarımı sağlasa da arkasında ciddi etik ve hukuki soru işaretleri bırakmaktadır.
Sadece Sonuç Değil, Kaynak da Etik Olmak Zorunda
Yapay zekâ etiğinde uzun süredir verilerin telif hakları, kişisel verilerin korunması ve rıza mekanizmaları konuşuluyordu. Distilasyon tartışması ise bu boyutu yeni bir evreye taşıyor.
Kullanım Şartları İhlali: Bir API üzerinden hizmet sunan şirketler, çıktıların rakip modelleri eğitmek amacıyla kitlesel olarak çekilmesini açıkça yasaklar. Sahte profiller veya coğrafi kısıtlamaları aşan sistemlerle veri toplamak, açık bir güven ihlalidir. Bir teknolojinin etik sayılabilmesi için, öncelikle erişildiği kaynağın kurallarına dürüstçe uyması gerekir.
Kimlik Şeffaflığı: Distile edilen modeller, eğitildikleri orijinal modellerin izlerini taşır. Nitekim bazı sohbet robotlarının kullanıcılara kendilerini Claude olarak tanıtması, bu kontrolsüz distilasyonun en somut göstergelerindendir. Ürünün kaynağı ve eğitim arka planı şeffaf değilse, güvenilir bir yapay zekâdan söz etmek mümkün değildir.
İnovasyon Parazitliği: Öncül modelleri geliştirmek; güvenlik hizalaması, insan geri bildirimiyle pekiştirmeli öğrenme (RLHF) ve devasa altyapı yatırımları gerektirir. Bu emeğin telifsiz ve izinsiz bir biçimde süzülerek başka modellerin içeriği haline getirilmesi, sürdürülebilir inovasyon ekosistemine doğrudan zarar verir.
Yapay Zekâ Yönetişimi Açısından Ne Anlama Geliyor?
Geleceğin yapay zekâ düzenlemeleri, yalnızca girdi verilerini değil, sentetik verilerin kökenini ve model içi öğrenme kaynaklarını da denetlemek durumundadır. Bu bağlamda üç kritik alan öne çıkıyor:
Sentetik Veri İzlenebilirliği: Modellere eklenecek filigran ve izlenebilirlik teknolojileri, bir çıktının hangi modelden türetildiğini tespit etmede belirleyici rol oynayacak.
Etik Tedarik Zinciri: Kurumsal yapay zekâ benimsemelerinde şirketler, kullandıkları modellerin yalnızca performansına değil, eğitim verilerinin ve distilasyon kaynaklarının etik standartlara uygunluğuna da bakmak zorunda.
Küresel Şeffaflık: Yapay zekâ laboratuvarlarının modellerini eğitirken hangi kaynakları kullandıklarını açık ve denetlenebilir bir biçimde kamuoyuyla paylaşmaları gerekmektedir.
Son Söz
Yalnızca performans odaklı ve sonuca giden her yol mübahtır anlayışıyla geliştirilen modeller, uzun vadede etik ve hukuki krizlerle karşılaşmaya mahkûmdur. Bir yapay zekâ modelinin ne kadar zeki olduğu kadar, bu zekâyı hangi kaynaklardan, ne kadar dürüst ve şeffaf yollarla edindiği de onun gerçek değerini belirleyecektir.
Etik bir yapay zekâ geleceği, yalnızca temiz veriyle değil; dürüst, şeffaf ve saygılı bir geliştirme süreciyle mümkündür.
Hukuki Uyarı
Bu içerik genel bilgilendirme amaçlıdır ve hiçbir şekilde yatırım, hukuki veya mesleki tavsiye niteliği taşımaz. Yazıda geçen marka isimleri ilgili şirketlerin tescilli markalarıdır ve yalnızca açıklayıcı amaçlarla kullanılmıştır. Herhangi bir ortaklık, sponsorluk, reklam veya ticari ilişki bulunmamaktadır. İçerik tarafımca oluşturulmuş olup, yazılı izin olmaksızın ticari amaçlı kullanılamaz. Harici linkler yalnızca bilgilendirme içindir ve bu sitelerin içeriğinden sorumlu değiliz.
Görseller yapay zeka ile oluşturulmuş olup yalnızca içeriği destekleme amaçlıdır.
#reklamdeğiltavsiye #YapayZeka #ÜYZ #AIEtik #ModelDistilasyonu #AIGov #Anthropic #DeepSeek #SentetikVeri





Bir Cevap Yazın